

网上有很多分享skill的教材,你或许跟我一样,经常是收藏了一堆,想不起来用。最核心的原因就在于内容太多,但不见得是自己需要的。我整理这篇教材,目标就是帮你挑出哪些对你有用?
11 个做科普动画的 Skill,分别能产出什么样的结果,今天我替大家了解清楚,看完再用,会帮你节省一些试错的时间。
当然,工具好与坏更多在于使用人的创意。
这里先给大家重点说下区别,这些skill有的是用模型画的,有的是用代码画的。模型画得快、够像,但改一遍需要再花一遍积分;而代码虽然画得慢一点,但改个数字重跑,不花钱。大家注意根据自己的需求,在使用时主要自己的口袋。
01 · 只出一张图 | visual-explainer-skill
丢一段文字进去,出来一张能直接当配图的信息图。
▲ 内容被切成区块,编号、箭头连起来,像一页印好的海报
运行速度非常快,他的原理是内容先被拆成概念、关系和版面,写成一段很长的提示词,丢给图像模型去画。
风格、信息密度都能调,还能切成多帧递进,或者套进手机和电脑的框里。
图上别放中文小字。这类模型写字十有八九是糊的,英文也常缺笔画。
02 · 只出一张图 | anatomy
擅长把抽象概念具象化。

▲ 令牌桶被造成一台机器:罐子、令牌、进料口、出料口、右下角读数
出来的是 SVG 或 HTML,从后往前一层层堆。而且非常慢,需要表述的很清楚。
03 · 引擎 | hyperframes
一个把网页渲成 MP4 的skill。

▲ 官方那句: It’s just HTML .就是它的世界观。
让 Agent 写一个网页,引擎一帧一帧截图,合起来就是视频。
效率非常快,而且改动不需要耗费模型积分。后面好几个 skill 就跑在它上面。
04 · 代码画帧 | knowledge-explainer-skill
写一份 Markdown,一行命令直接出 720p 成片。

▲ 比较省事,一句命令,它自己拆场景、生成 React、调 Remotion 渲出来
内置了六种版式:标题页、知识点卡、双栏对比、几何题、前后对比、收尾大字。所以只用内置的会带点 PPT 味。
想好看,得让它往 custom 目录里写组件。
05 · 模板 | AI-Animation-Skill
能全屏播放的演示动画。

▲ 深色科技风:左边分层列表逐条进场,右边浮一张立体卡片
出的是 HTML,纯 CSS 加 3D transform,成本几乎为零。
模板感比较重。
06 · 代码画帧 | animated-explainer-skills
Kurzgesagt 那一挂,深蓝夜空加手绘小角色。

▲ 给的不是模板,是一套编排模式:挤压拉伸的落体、物体变形的转场、带暗角和颗粒的镜头、分景深的视差推轨。
换内容,不换骨骼。
07 · 手绘 | whiteboard-explainer
一只手拿马克笔,说到哪个词就画到哪一笔。

▲ 纸、马克笔、照片级的手、半画完的引导线
它不描 SVG 笔画,描边画出来的东西上限就是火柴人。走的是白板工具的老路子:先出成品插画,再用蛇形蒙版一点点揭开,一只手跟着笔尖走。
节奏来自 Whisper 的词级时间戳。说到哪个词,笔就落到哪一笔,不用估时长。
要图像模型、TTS、Whisper、HyperFrames 四样齐了才跑得动。
白板里最贵也是最慢的一个。
08 · 数学 | manim_skill
3Blue1Brown 那一套,公式是真排的,曲线是真算的。

▲ 近黑底、细线、金色曲线、LaTeX 公式,那条渐变面积一眼认得出
它其实是两套规则集,ManimCE 和 ManimGL 各一套,管的是让 Agent 写 Manim 的时候别犯低级错。公式用 LaTeX 排,曲线按函数算,中间那几步变换在数学上对得上。
Python、FFmpeg、整套 LaTeX,光装环境就能劝退一半人。它的输入是题目或概念,不是文案。
09 · 流水线 | explainer-video-skills
五条产线打成一包,最值钱的是能批量。

▲ isometric 产线:三层结构逐层升起,虚线连出调用关系
iart 官方出的包,一个仓库里五个技能:脚本分镜配音对齐、年度报告风、图表逐节点揭示、白板、等轴测。
最有用的那个叫 wrapped-video。一个模板配一张数据表,能出几百条 9:16 的短片。它把视频从作品变成了批处理,另外十个都没这能力。
10 · 模型画帧 | vox-explainer-skill
一句话,给你输出一条 Vox 风纪录片。

▲ 撕纸边、半调网点、压缩体大字、红黑米白
脚本、配音、关键帧、微动、配乐、拼装,全自动。一条 60 秒大概 3 到 8 美元,钱主要花在动画上。
画面靠约束收敛:先定一张风格锚帧,后面每张拿它当参考改,再禁掉镜头推拉和 3D 旋转,只留拼贴式的微动。
文字上屏会飘,中文尤其,标题字有时候会错一个。要的主要是那股老照片加剪贴画的味道。
11 · 模型画帧 | higgsfield-video-explainer
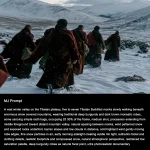
整条片拆成一个个 10 秒块,一块配一句旁白。

▲ 黄昏手绘感的叙事画面,字幕烧在片上,右上角标着第几块
先锁风格,再写脚本,然后一口气把所有配音生成出来,最后才出画面。每块十秒,画面和旁白一对一,不会出现画面太短配不完这句话的事。风格不用描述,从预设库里看缩略图挑。
要装 CLI 登录,难道不是难,就是用一次消耗一次积分。
汇总
| Skill | 结果 | 帧谁画的 | 门槛 |
|---|---|---|---|
| visual-explainer | 单张大图 | 图像模型 | API Key,最低 |
| anatomy | SVG / HTML / PDF | 代码(等轴测) | 零依赖,但很慢 |
| hyperframes | MP4 | 代码(HTML→帧) | Node / FFmpeg |
| knowledge-explainer | 1280×720 MP4 | 代码(Remotion) | Node / FFmpeg,低 |
| AI-Animation-Skill | HTML 演示页 | 代码(CSS) | 无,零成本 |
| animated-explainer | HTML(可录屏) | 代码(GSAP) | 会编排才行 |
| whiteboard-explainer | MP4 | 插画模型 + 蒙版 | 四件套齐全,高 |
| manim_skill | MP4 / 图片 | 代码(Manim) | Python + LaTeX,最高 |
| explainer-video-skills | MP4,可批量 | 代码(五条产线) | 中等,工具齐全 |
| vox-explainer-skill | 60 秒 MP4 | 图像 + 视频模型 | $3–8/条 |
| higgsfield-video-explainer | MP4(10s 块) | 图像 + 视频模型 | CLI + 额度 |
以上,其实我们发现,这些skill都有各自的亮点,我个人觉得,最好是组合起来,根据需求的不同灵活搭配起来用。同时,还要考虑花费积分这个成本。
写公众号配图,我会用visual-explainer 出常规配图,碰上值得盯的选题就拿 anatomy 做一张主图。两张加起来不到一段视频的零头。
做长视频,我会用hyperframes 做片头,animated-explainer 做主体,碰到公式可以丢给 manim。
如果要那种比较高级的效果,就只能走 vox 或 higgsfield。注意尽可能表述号需求,避免二次改动花费更多积分。
欢迎评论区分享使用感受和方法。