












中国第一家大语言模型公司,就是MiniMax。开源不是慈善。
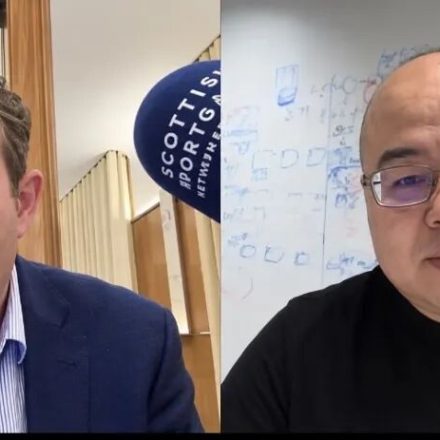
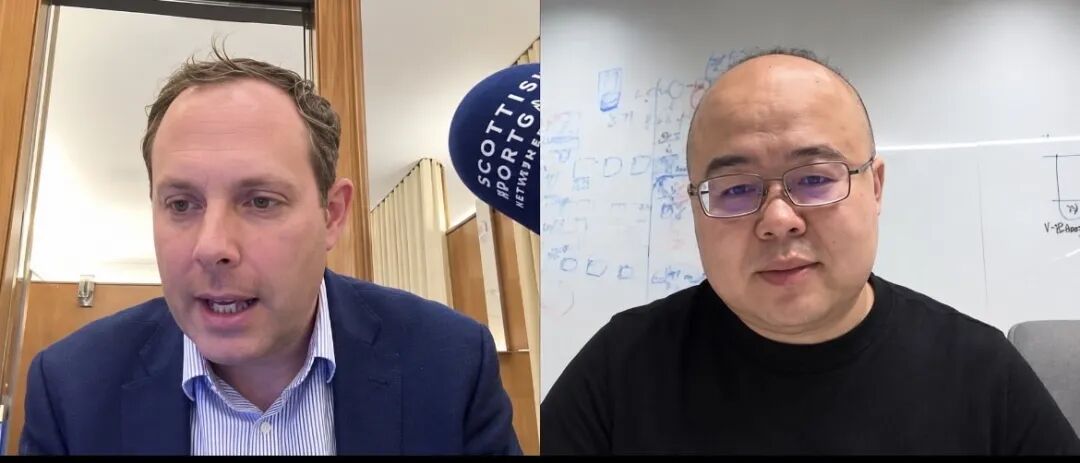
2026 年 11 月 3 日,Baillie Gifford 旗下 Scottish Mortgage 的官方播客 Invest in Progress 上线了最新一期:《MiniMax: The Chinese AI Lab Doing More With Less》。
主持人Claire Shaw表示,这是MiniMax创始人闫俊杰,第一次接受英文播客访谈。
采访者是 Scottish Mortgage 副经理、BG 合伙人 Lawrence Burns。去年 12 月,他飞了一趟中国,在 MiniMax 上市前见了闫俊杰一面。
今年 1 月,Scottish Mortgage 参与了 MiniMax 的港股 IPO。
Baillie Gifford,一家 1908 年成立的机构,投过亚马逊、腾讯、特斯拉、英伟达,也在 MiniMax 港股 IPO 时买了 2000 万英镑。
全文约 53 分钟。本文实录基于 Scottish Mortgage 官网发布访谈直播,口语重复与语气词奇偶工作室进行了修剪,问答内容保持完整。
开场
先认识一下对话里的人。
闫俊杰(IO):MiniMax 创始人,董事长兼 CEO,兼 CTO。河南小镇出身,机器学习博士,曾在百度深度学习研究院做研究实习生,导师是余凯。
Lawrence Burns(LB):Scottish Mortgage 副经理。2021 年上任,2009 年加入 Baillie Gifford,2020 年成为合伙人。
Claire Shaw(CS):Scottish Mortgage 组合总监,主持人和开场旁白。
Invest in Progress 是 Scottish Mortgage 的旗舰播客,形式固定:投资经理对话被投公司创始人,最后由投资经理复盘投资逻辑。这一期的结构也不例外。
正片前先放访谈片段的精华。
闫俊杰:对我们,尤其是中国的一家 AI 公司来说,算力从来都是一个约束。而这个约束让我们成了更好的工程师和研究者。
Burns:我第一次见 IO(闫俊杰昵称) 是去年 12 月。最让我们好奇的是,用他自己的话说,MiniMax 能以头部前沿模型大约 95% 的性能水平,做到只有十分之一成本。
闫俊杰:我认为,美国生态在用巨额资本建设封闭系统,而中国生态在用效率建设协作。
Burns:这种低成本模式和美国看到的很不一样,它在全世界可能都非常有价值。第一,不是所有工作都需要最顶尖的水平;第二,不是所有用户和企业都像欧美的用户和企业那样付得起钱。
闫俊杰:AGI 不应该属于任何一家公司、任何一个国家或者任何一个组织。它必须属于我们所有人。
MiniMax 的访谈的骨架:穷、快、开源、平权。
1、MiniMax 的战略
就是MiniMax
Burns:IO,非常感谢你今天来做客。我们上一次聊,还是去年 12 月我去中国见你,就在 MiniMax 上市之前,Scottish Mortgage 作为 IPO 的一部分投资了你们。先恭喜你们成为上市公司。还是从一个老问题开始吧:MiniMax 是做什么的?公司想解决什么问题?
闫俊杰:我们试图解决的问题,我觉得非常简单,就写在名字里。我们要最小化推理成本,同时把智能的边界向每个人最大化扩展。在 LLM 或者 AGI 这些概念变成主流之前,我们就是中国第一家 AGI 公司。我们相信,智能的红利不应该是有限的,它应该与每一个人分享。
(奇偶工作室:MiniMax 的名字即 min(最小化推理成本)+ max(最大化智能边界)。推理(inference)指模型训练完成后,每次回答用户问题时的计算过程,这是 AI 公司最大的持续性成本项。)
Burns:对你来说,AGI 意味着什么?它到来的时候,我们怎么识别它?
闫俊杰:我认为 AGI 意味着 AI 能提出新的理论。意味着科学的下一次重大突破,主要由 AI 来完成。
2、M 系列和 H 系列
Burns:给不熟悉你们产品的听众简单介绍一下,主要产品面向消费者和企业各做什么?
闫俊杰:我们有一些产品,但现在已经收敛成两条模型产品线。第一条是 M 系列,语言模型,面向智能与生产力场景,比如编程和智能体(agent)。
第二条是 H 系列,视频生成模型,横跨视频、图像和音频。
闫俊杰补充:目前 H 系列的旗舰是 H3,完全开源,通过 API、开放权重和 MiniMax 自己的产品三种方式提供。过去一个月,H3 成了全世界下载量最大的开放权重模型,一个月下载了大约 2500 万次。
我们不认为这两个世界永远分开。两条线都会继续 scale,下一步是合并成一个统一模型。可能就在未来几个月。
3、河南、GPU 和爷爷的回忆录
Burns:你是创始人,也是董事长、CEO 和 CTO,很多事情压在你一个人身上。先聊聊你走到今天的路。
你在中国河南的一个小镇长大,那里是农业重地。你父亲在当地学校教数学,你很早就显露出数学天赋。回想起来,你很年轻就在做大学水平的数学题。是什么驱动你投入那么多额外的时间?
闫俊杰:河南在中国的中部,”河南”的意思是黄河以南,黄河是中华民族的母河。我小时候家里到处都放着书,我很小就大量自学。到中学的时候,我已经在学一些大学水平的数学和计算机科学了。
真正吸引我的是数学和计算机科学的结合。它让我能用算法和数学,通过编程解决真实世界的问题。这自然把我引向机器学习,在那个时候,那还是个相当独特的领域,大概是 20 年前。所以本科毕业后我决定读机器学习方向的博士,因为我相信,只要把这些方法 scale 得足够远,AI 最终会强大到非常有用。
Burns:你 2014 年还在百度的深度学习研究院待过,当时的负责人是余凯博士,老听众知道他后来创办了自动驾驶公司地平线,那也是我们的持仓之一。那段经历给你留下了什么?
闫俊杰:余凯博士帮了我很多,他是我当时的导师,我还是个博士生,已经发了大概几十篇计算机视觉的论文。但真正让我震撼的是多伦多大学的 AlexNet 论文。那篇论文给出了一种用深度学习做图像分类的方法,我觉得那是一个巨大的突破。
所以那时候我想去一家全世界 GPU 最多的公司。当时百度是英伟达最大的客户,意味着它有全世界最大的 GPU 集群。而且百度那时候非常开放,作为一个研究实习生,巅峰时期我能用到百度三分之一的 GPU。
我用这些 GPU 做了大量图像分类、目标检测的研究,那一年我们参加了 ImageNet 挑战赛,我和我的搭档——他也是实习生——拿到了第三名。
(奇偶工作室:AlexNet 是 2012 年引爆深度学习革命的图像识别论文。ImageNet 挑战赛是计算机视觉领域最重要的竞赛,2012 年正是 AlexNet 夺冠掀翻传统方法的一年。闫俊杰参赛拿到第三,是在那之后的两三年。)
Burns:还有一些个人经历塑造了你对 AI 的信念。我听说的一个,是你爷爷想写一本回忆录,但很难做到。这件事给你留下了很深的印记。
闫俊杰:是的,这是另一个动机。这也是我在 ChatGPT 出现之前就觉得通用智能很重要的原因。传统的计算机视觉、语音识别,只有大公司能用,普通消费者用不上。所以”通用”很重要。
(奇偶工作室:这段没有展开,但意思大概是:技术如果不能到每个人手里,就不算数。这个判断后来写进了公司的名字。)
4、ChatGPT 前夜
Burns:你在 2021 年 12 月创立 MiniMax。第一款消费产品是 Glow,一个能和虚拟角色聊天的平台,很快积累了数百万用户。不久之后 ChatGPT 发布了,它彻底改变了消费端。我好奇的是,它的发布如何改变了你对 AI 发展节奏的判断?
闫俊杰:MiniMax 的第一年,我们只知道 AGI 很重要,但没有时间表。第一年我们就是在建基础设施,训练最初版本的语言模型和图像、音频生成模型。我们想做一个 app 来测试和验证模型的性能,这就是 Glow。我们没料到会有那么多用户,当时只是想做一个实验。
大概四个月后,ChatGPT 发布了。它改变了我们对时间表的感知。它让我们意识到,scaling 必须比我们预想的大得多、快得多。于是我们开始 scale 基础设施、scale 数据、scale 模型的尺寸。
Burns:它是一个催化剂?
闫俊杰:对。其实在 ChatGPT 发布之前,中国只有一家公司在做大语言模型——就是 MiniMax。
ChatGPT 之后,中国很快有了大概 20 家做大语言模型的公司。竞争变得非常激烈。
5 为什么死磕多模态
Burns:你从一开始就把多模态放在战略核心:文本、图像、视频、音乐、语音都要生成。OpenAI 反而收窄了路线,比如砍掉了视频。多模态显然会摊薄资源。为什么这对你是正确的路,而不是聚焦一两件事?
闫俊杰:真正的原因是,MiniMax 刚开始的时候,我们并不确切知道它最终会是什么形态。所以我们就把每个方向都 scale 起来,等技术积累够了再把它们合并。多模态丰富了数据多样性,是未来 scaling 的必由之路。但它也确实带来更多挑战。如果一开始只聚焦单一模态,我们可能初期进步更快。
不过,多模态正是我们区别于其他公司的地方。
6、Agent 的下一步
自己定目标
Burns:你说过智能体(agent)会成为主要增长驱动力。你们把自己的 agent 品牌命名为 Mavis,定位是能规划并完成复杂任务的 AI 管家。你怎么看 agentic AI 的增长机会?它要释放全部潜力,还需要发生什么?
闫俊杰:我认为 AI agent 的下一个前沿,不是在长程任务上和人类竞争,而是自己形成目标、自己验证结果。也就是长程任务上的自主性。我认为这就是未来。在当下,我们把编程能力和 agent 能力作为 M 系列模型最重要的两件事。
实际上,这个月我所有的时间都花在我们的下一代模型上。M3 Pro。我认为它会是这个时代的一次大突破。虽然它还没有完成。
7 利润的算法
Burns:和很多 AI 公司一样,你们目前还在亏损。只要能看到飞轮在转,产品能力越强,用的人越多,收入越多,再投入研发,最终走向盈利,我们对此没有意见。MiniMax 是这么想的吗?你凭什么相信长期能盈利?
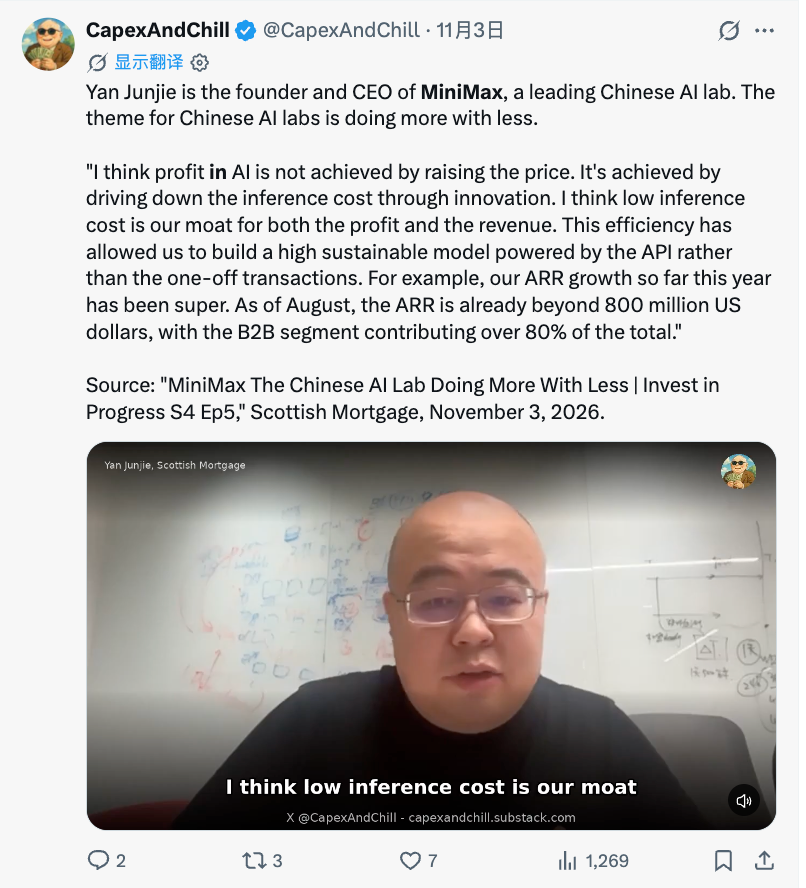
闫俊杰:我认为 AI 的利润不是靠提价实现的,是靠创新把推理成本打下来实现的。低推理成本是我们利润和收入的双重护城河。
这种效率让我们得以建立一个由 API 驱动的高度可持续的商业模式,而不是一次性交易。
比如今年我们的 ARR 增长非常好,截至 8 月,ARR 已经超过 8 亿美元,其中 B2B 占比超过 80%。只要模型性能持续提升、价格 leadership 保持住,收入增速一定会超过成本。这是我们的完美计划。
(奇偶工作室:ARR(annualized revenue run rate,年化收入运行率)指把当月收入乘以 12 得到的年化口径。)
8 最后 5% 最难追
Burns:回到你去年 12 月说的那句话:中国最好的模型性能大约落后美国头部 5%,但成本低 10 倍。这十个月里,能力和价格的差距怎么变化的?
闫俊杰:我认为重要的不是某一个时点的差距,而是改进速度的提升。因为无论美国模型还是中国模型,都还处在通往 AGI 的非常早期的阶段。
第一,那 5% 的差距,可能比前 95% 都难追得多。所以我认为目前的差距可能需要一些时间来解决。我们还处在 AGI 的非常早期,重要的是我们能改进得多快。
对我们来说,尤其是一家中国 AI 公司,算力从来都是一个约束。所以从第一天起,我们就知道必须让推理尽可能高效。实际上,过去三年,双方的改进速度已经大致相当了。我们关注的是进展的速率,不是某个时点的排名。这引导我们去做架构创新和芯片之外的基础设施创新。
我们相信,如果能更高效地使用算力,就一定能做多得多的后训练(post-training),把模型推得更远。这可能给我们一条不同的智能 scaling 路径。
(奇偶工作室:post-training(后训练)指模型预训练完成后,通过强化学习、数据合成等方式继续训练的阶段。过去几年模型能力最大的几次跃迁,写代码、做 agent,主要来自后训练。后训练的每一步都消耗推理算力,所以推理成本直接决定后训练的规模。)
Burns:可以这么理解吗:美国的前沿实验室被算力宠坏了,他们非常成功地推动了前沿,但从来没有像你们这样,从第一天就被逼着重视效率?
闫俊杰:是的。中国顶尖的前沿实验室都在聚焦效率,但我们用的方法各不相同。比如在 Transformer 里用不同的架构,在后训练里用不同的基础设施,聚焦不同的模态。你能看到中国不同前沿实验室的模型是不一样的,但它们都有用。
9 开源不是慈善
Burns:中美 AI 的另一个重大分歧是闭源和开源。OpenAI、Anthropic 是闭源。开源在中国更流行。开源模型允许别人免费下载、在第三方硬件上运行。你怎么看两者的优劣?
闫俊杰:我认为开源不是变现的对立面,而是变现和进一步创新的催化剂。比如我们刚说的 H3,发布头两周,就有大约 300 个基于 H3 的开放模型被做了出来。这是对我们的模型而言最好的创新反馈回路。
举个例子:那 300 个模型里有个很有名的,是美国公司 fal.ai 做的 H3 Max,在 H3 的基础上做后训练,速度快得多。它 3 秒钟就能生成 5 秒钟的视频,是一个实时视频生成器。
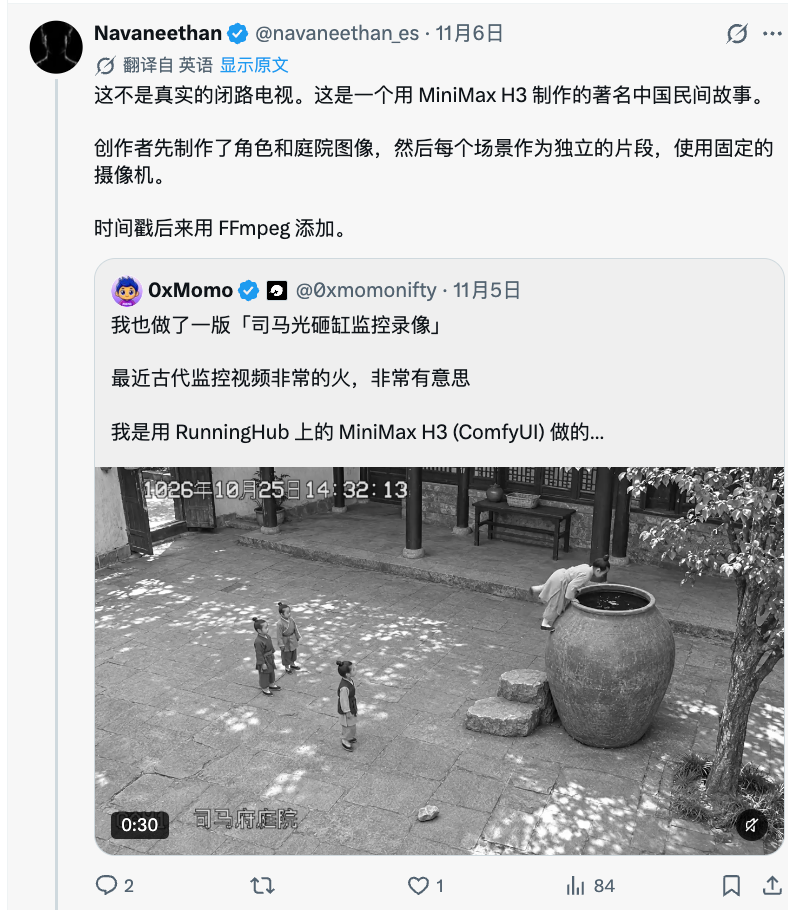
这种速度带来了完全全新的视频用法,以前根本不可能。比如开发者做出了 24 小时不间断的 AI 直播,内容根据你想看的东西实时生成。同样的能力可以让实时游戏、教育和很多其他交互体验成为可能。
第二个优势是,当客户能自己托管开放权重模型时,他们能保护自己的数据和隐私。这对企业和政府很重要。所以开源对模型公司、对用户、对开发者是三赢。我们计划一直开源下去,直到实现 AGI。
10 500 人的纪律
Burns:聊聊 MiniMax 的文化。用三个词形容的话,是扁平、聚焦、节俭。你倾向于内部培养人才,而不是花极高的薪水从别处挖人。这种文化在多大程度上是被你们所处的约束塑造出来的?
闫俊杰:这是个重要的问题。我认为文化来自算力和资本上的约束。我们其实只有 500 人,所以必须聚焦在真正重要的事上。我们的研发有两条核心原则。
第一条,把东西做简单。尽管我们有不同的模型,但我们的架构和基础设施非常简单。
第二条不一样:始终建设基础设施。建基础设施有时候比直接发产品要慢,但它是我们 scale 的地基。
基于这两条原则——把东西做简单、始终建基础设施——其他的差别,比如资本效率、组织效率,都是约束之下自然长出来的结果。
11 推理成本压得极低
Burns:中国和很多中国实验室把推理成本压得极低。这让我想问:如果全世界都像你们一样高效,对算力和英伟达芯片的需求还会像人们预期的那么大吗?还是说这就是杰文斯悖论,成本降下来,用量会升上去,人们永远想要更多芯片?
闫俊杰:首先,我们的架构设计原则是,无论用什么芯片都能跑得好。我们能做到的是三个领域的技术领先:模型架构、基础设施、优化。这三样东西在硬件受限的时候反而更值钱。约束让我们成了更好的工程师和研究者。算力越受限,算法和推理就越重要。
Burns:回到更宏观的视角。中国 AI 生态和美国相比,各自的强项和弱项是什么?这会导向什么样的技术和产品创新?
闫俊杰:我认为美国生态在用巨额资本建设封闭系统,中国生态在用效率建设协作。美国公司有更多算力、更多资本、更多芯片获取渠道;中国公司被迫把每一单位算力用到更高效。
我不认为两个生态会收敛到同一条路上。开放对封闭、高效对资源充裕——这些差异会塑造各自生态最终能造出什么。
12 壁垒
Burns:在中国内部,你们的对手是字节跳动这样雄心勃勃、资金雄厚的大公司,还有阿里巴巴,以及 ChatGPT 之后冒出来的 20 多家生成式 AI 创业公司。
听众应该怎么理解 MiniMax 相对这些对手的壁垒?
闫俊杰:大公司,无论中国还是西方,都是在为很多不同的业务做优化;而我们只为一件事做优化:建设最高效、能力最强的多模态 AGI。我们相信,效率本身就是智能的一部分。你对算力的使用效率越高,能 scale 得就越远。开源是我们的另一个优势。比如在中国,字节跳动是闭源的,我们是开源的。
在我们模型上做开发的开发者,把它推向新的应用场景,形成帮助我们更快改进的反馈回路。还可以拿 H3 举例:字节的 Seedance 是闭源的,生成的效果不好,速度还很慢。而基于 H3 的开放模型可以做到实时。这带来了全新的东西。
最终,我们想把自己最好的语言模型和视频生成模型合成一个系统。我们认为那会打开一个作为单一模型的大得多的机会。这就是 MiniMax 的壁垒。
13 AGI 属于谁
Burns:最后一个问题,我们问每一位来节目的创始人:如果 MiniMax 实现了它的愿景,世界会变成什么样?会改变什么?
闫俊杰:我认为问题不是 AGI 能不能实现,而是它会造福谁。AGI 太重要了,它不应该属于任何一家公司、任何一个国家或者任何一个组织,它必须属于我们所有人。这就是我持续做这件事的原因:实现 AGI,确保智能与每个人同在。
更大的问题是,如果世界上有了更多的智能,我们对世界、乃至宇宙的理解,会不会改变?我认为会。这种可能性就是驱动我的东西。
Burns:也就是说,开放权重模型让 AI 的力量扩散到更多人和组织,因为他们对 AI 有一种所有权——它是开源的,他们在它之上构建,不依赖另一家公司持续供给你这个模型。这是关键所在?
闫俊杰:是的。所以我们的口号是 intelligence with everyone,而不是 intelligence for everyone。因为我认为它属于每一个人。
(奇偶工作室:给所有人(for everyone)是分发,与所有人同在(with everyone)是共有。)
14 投资人怎么看
正片结束,主持人 Claire Shaw 留下 Burns 做例行的投资复盘。
BG 到底为什么投资 MiniMax?
Claire Shaw:最让我着迷的是 IO 说的,中美 AI 生态不会收敛到同一条路上。拿不到美国对手那么多顶级芯片,反而成了 MiniMax 的长期优势。
Burns:三件事。第一件是我去年 12 月第一次见 IO。我们对他本人、对中国 AI 生态听到的信息非常好奇——用他自己的话说,MiniMax 能以头部前沿模型 95% 的性能、十分之一的成本交付。
第二件,是我们非常钦佩这种成本优势是如何长在公司的骨子里的。它生于稀缺,这塑造了他们做事的方式,给了我们一种比当初认知更结构性的优势。他们没有同等级别的高端 GPU 获取渠道,所以 IO 把公司建成了这样一个形态:从每一小时算力里榨出更多有用功,让芯片时刻满载,把成本放在模型设计的中心。
这个模式和美国很不一样,在全世界都可能非常有价值。第一,不是所有工作都需要最顶尖的水平;第二,不是所有用户和企业都像欧美那样付得起钱。
第三件事是 IO 本人。他是一位备受尊敬的 AI 科学家,同时是一位很好的资本配置者。这个组合非常罕见。所以我们认为值得支持他。
还有一点,AI 作为一项技术发展得非常快,美国和加州在发生有趣的事,中国也在发生有趣的事。只有同时和这两个生态保持接触,你才有更好的机会理解 AI 会怎么发展。只看其中一个,这个工作会难得多。所以我们认为,对中国生态保持一定敞口非常重要。
Burns:对我们来说,MiniMax 这一路波动不小。我们 1 月在 IPO 时投资了大约 2000 万英镑。上市之后股价反应非常强烈,这让我们取出了 4000 万英镑——是投入的两倍——同时仍持有大约 2000 万英镑的头寸。所以对我们来说,这是一笔不错的投资,更是一次极好的学习机会。
Burns:AI 实验室普遍的做法,尤其在美国,是花大钱在训练模型之前做大量实验,看哪些路线走得通。他们有资本、有芯片这么做。IO 最难得的能力是大幅收窄实验的押注范围,做更少的选择,因此资本效率更高,但依然能拿到好结果。在中国 AI 生态里和他共事多年的人说,这是他最大的强项之一:比别人更早看清技术要往哪走。
Claire Shaw:再深入聊一下商业模式。通过压缩每次回答的成本,公司可以给客户更低的价格、赢得更多业务。但 IO 还提到了第二点,不那么显眼:成本低,意味着模型发布之后,公司负担得起更多改进工作。
Burns:低成本是他们一切的中心,第二点也非常重要。极简地讲,AI 模型先消化大量数据获得知识,这叫训练;之后还有一个阶段叫后训练,模型在那里反复练习完成任务,学习什么有用什么没用。过去几年模型能力最大的几次飞跃都来自后训练。而练习是贵的——每一次练习都是在向模型提问,都有成本。
打个比方:两个高尔夫球手,都会因为练习而进步,但其中一个的练习球便宜得多。其他条件相同的情况下,能拿到更多更便宜练习球的人,球技会更好。这个比喻里,MiniMax 就是练习球更便宜的那一个,同样的预算能练更多。所以便宜的回答不只是让终端用户和企业用得起,它让产品能以更快、更省钱的方式持续变好。
15 风险清单
Claire Shaw:MiniMax 增长很快,但风险也要谈。公司还在亏损。IO 的想法是收入增速超过成本增速来实现盈利。你觉得最大的挑战是什么?
Burns:这个挑战是真实的,不应该回避。今年上半年收入接近翻了两番,但报告亏损大约是收入的 3 倍。熟悉 AI 实验室公司的人都会注意到,这个量级的投入并不罕见。
但最终,你需要一个能盈利的模型。
我认为有两个真实的挑战。第一,中国的价格竞争极其激烈——你在和 DeepSeek 这样的对手竞争。第二,追平前沿的成本在持续上升,这就是 MiniMax 7 月融资 20 亿美元的原因。
解法就是我们谈的这些:保持精简的成本结构、做正确的技术选择、在收入能规模化的市场增长。关键的一点是,模型每进步一代,就给公司解锁更大的市场。现在研究支出的增速已经低于销售增速,这是个好信号。销售也在从消费者端转向企业端——企业收入增长了大约 8 倍,现在占收入的 63%。IO 提到年化口径是 80%,你能看到这个趋势正在兑现。
但我们必须说清楚:退一步看,这是一个早期持仓。它高度不对称——通往成功的路有很多条,但可能的结果分布也很宽。这也是为什么它在组合里的仓位是这个规模。
16 市场有多大
Claire Shaw:最后一个问题。IO 说,把更强的 AI agent 和 MiniMax 最好的语言模型、视频模型合成一个系统,会打开更大的机会。但这个行业变化太快,很难判断。作为长期投资者,你觉得 MiniMax 服务的市场能有多大?
Burns:这笔投资里我唯一不担心的就是市场够不够大。只要你能以更低的成本提供越来越强的智能,市场就一定在。市场会随着你的能力提升持续长大。
你提到把语言模型和视频模型合起来,这是个绝佳的例子。多数工作是多种技能的混合,而不是单一技能。今天的视频模型擅长生成片段,但不太能接受指挥——它没法像一个剪辑师那样修改这个片段,而这需要语言模型的理解力。一旦系统两者兼备,AI 就从”做片段”变成”承接整个项目”——广告、电影、设计。人们会为这种智能付高得多的钱。所以需求会随着一代代新模型的发布阶梯式地到来,比如 IO 描述的实时视频。这里真正的大问题是竞争、盈利能力和利润率,但市场规模本身,我们非常有信心。
访谈结束。